24GB Mac 做数字人:声音放本地,画面租云端
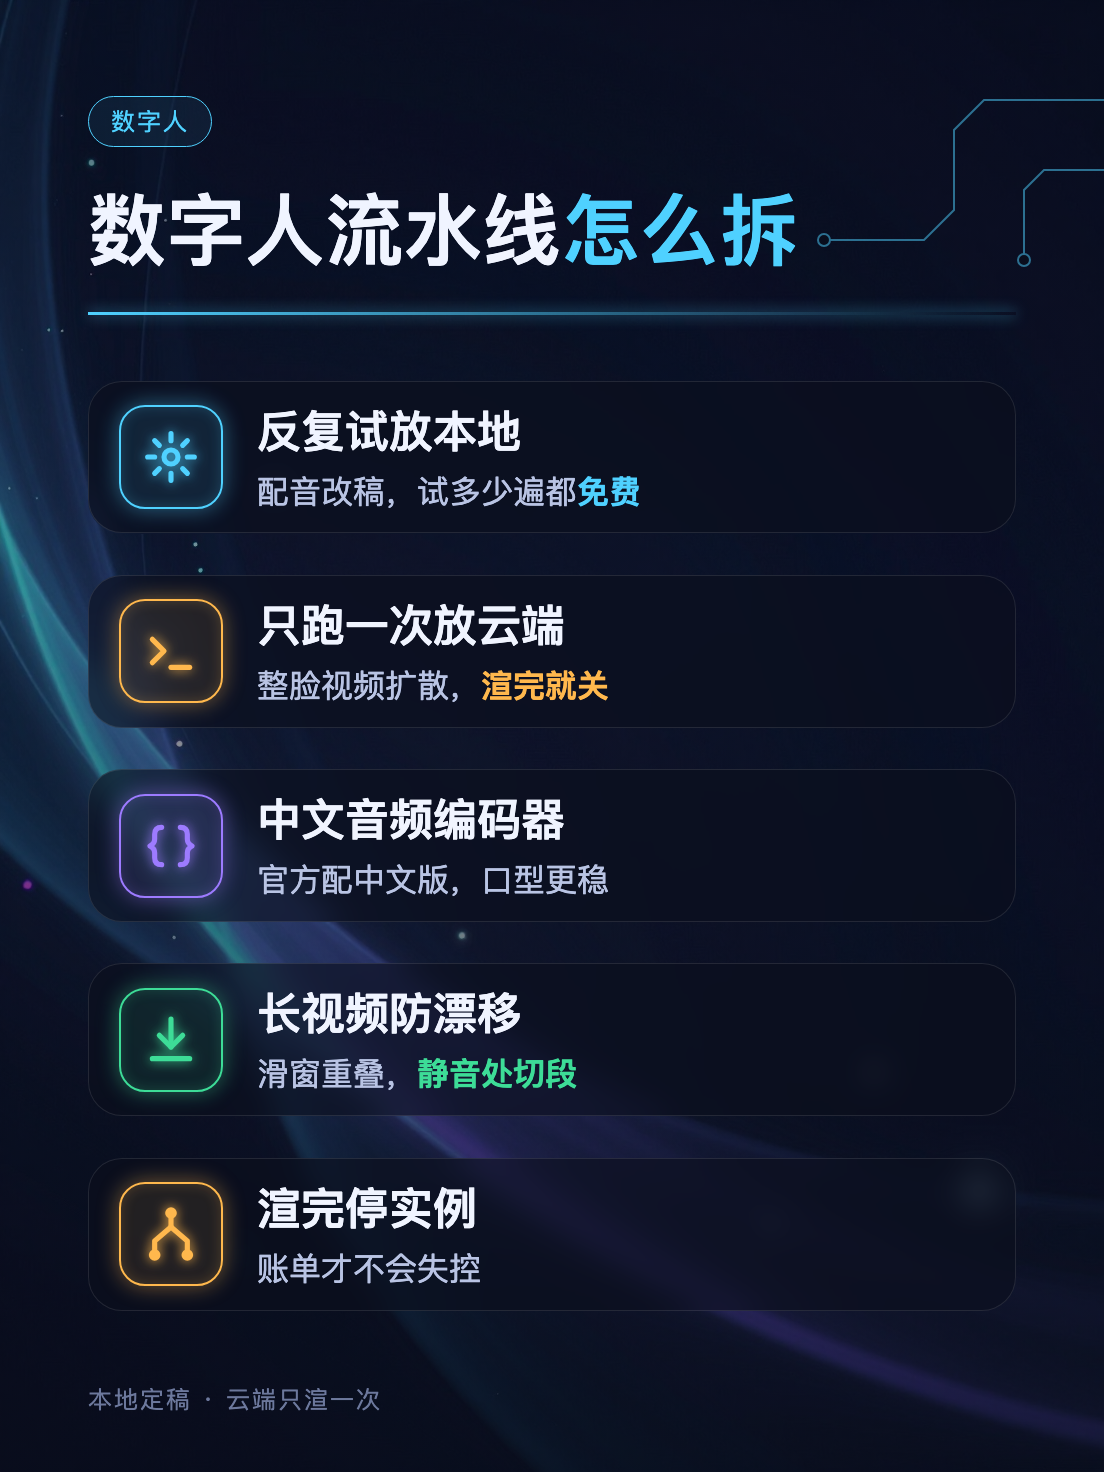
有人实测:14B 视频模型峰值要吃 36 到 55GB。
摘要
做口播数字人,最大的坑是想用一台机器包办。更省的做法是按“吃什么资源”把流水线拆开:配音很轻,留在本地;整脸驱动的视频扩散很重,临时租一张大显存卡,渲完就关。本文给出拆分原则、可运行的骨架、长视频防漂移的三个办法和一张排错表。
背景与问题:为什么不能一台机器包办
开源数字人这两年的进步很大。以 InfiniteTalk 为例,它不再只改嘴型,而是让头部、身体和表情一起跟着音频动。它基于 Wan2.1-I2V-14B-480P,音频编码器用的是 chinese-wav2vec2-base,支持 clip(单段)和 streaming(长视频)两种模式,靠上下文帧让相邻片段衔接。
问题是门槛。14B 的视频扩散模型,一位实践者记录的峰值占用是 36 到 55GB,24GB 内存的笔记本装不下。相反,语音合成这一半很轻:VoxCPM2 是 2B 参数的 TTS,官方称支持 30 种语言、输出 48kHz 音频,在 RTX 4090 上实时率约 0.3,也支持在 Apple 芯片上用 MPS 运行。
两个环节需求差了一个数量级,硬塞进一台机器,要么买不起,要么慢到没法用。
核心思路:按“吃什么资源”来切
我自己的切法只看三个问题:
| 环节 | 吃什么 | 放哪 |
|---|---|---|
| 文案改写、配音、切段、混音 | 少量算力,要反复试听改稿 | 本地,免费、随时重来 |
| 整脸视频扩散 | 大显存,一次跑几分钟 | 云端按小时租,渲完即关 |
| 最终放大、混音轨、成片 | 轻量 ffmpeg | 回到本地 |
背后的原则有两条:
- 需要反复试的放本地。声音好不好听,要试十遍;放本地,试多少遍都不花钱。
- 只需要跑一次的放云端。画面是烧钱的一步,所以先把音频定稿,再上云,云端只做一件事。
这样云端 GPU 的账单就只剩“渲染时长”,没有调试时长。
面向人群
- 有一台 16 到 24GB 的 Mac,想做口播、讲解类视频,但买不起大显存显卡的人
- 已经在用 ComfyUI,想把视频生成接进自己脚本的人
- 做过数字人但一直被“几十秒后画面变暗变色”困扰的人
实践步骤
第一步:本地把声音做到定稿
先装依赖(VoxCPM 要求 Python 3.10 到 3.12):
brew install ffmpeg
uv venv --python 3.12 && source .venv/bin/activate
uv pip install voxcpm soundfile numpy
文案一行一段,逐段合成后拼接。下面是骨架,参数名取自 VoxCPM 官方 README,接口以你安装版本的文档为准:
import numpy as np, soundfile as sf
from voxcpm import VoxCPM

model = VoxCPM.from_pretrained("openbmb/VoxCPM2", load_denoiser=False)
sr = model.tts_model.sample_rate                    # VoxCPM2 为 48kHz
pause = np.zeros(int(sr * 0.28), dtype=np.float32)  # 段间换气

REF = "ref_voice.wav"   # 试音阶段挑出的满意片段;还没挑时设为 None

chunks = []
for line in open("script.txt", encoding="utf-8"):
    line = line.strip()
    if not line:
        continue
    wav = model.generate(
        text=line,
        reference_wav_path=REF,     # 用参考音频克隆音色,长文不"换人"
        cfg_value=2.0,
        inference_timesteps=10,     # 越高越好但越慢
    )
    chunks += [wav, pause]

sf.write("voice.wav", np.concatenate(chunks), sr)
三个影响自然度的点:
- 别用播音腔。VoxCPM2 支持 Voice Design:把声音描述用括号写在文本开头,例如
(亲切松弛的年轻女声,像朋友聊天)今天聊一个……(官方示例用的是半角括号)。官方也提醒这类结果每次不同,可以生成 1 到 3 次挑最好的。 - 锁音色。挑出最顺耳的一段存成参考音频,填进上面的
REF,后面所有段落都用它做声音克隆。 - 改稿比调参数有用。书面文案里加几个“其实”“这里呢”之类的口语连接词,停顿和重音自然很多。
定稿后统一响度,避免嘴型驱动时音量忽大忽小。注意 loudnorm 会在内部把音频升采样到 192kHz,要用 -ar 指回 48kHz:
ffmpeg -i voice.wav -af loudnorm=I=-23:TP=-1.5:LRA=11 -ar 48000 voice_norm.wav第二步:云端只装必需的东西
云端用 ComfyUI,需要 kijai 的 WanVideoWrapper、KJNodes 和 VideoHelperSuite 三个插件。模型权重按用途放进对应目录:Wan2.1 I2V 14B 的 480p 量化版、InfiniteTalk 权重、中文 wav2vec2、umt5 文本编码器、VAE 与 CLIP Vision,再加一个蒸馏加速 LoRA(那位实践者用的是 LightX2V)。他记录的总量约 26GB,换版本可能不同。
两个提前注意的点:
- 音频编码器用中文版。InfiniteTalk 官方配的就是 chinese-wav2vec2-base,别随手换成英文 wav2vec2,中文口型对齐可能变差。
- transformers 版本要固定。那位实践者记录,在 transformers 5.x 下 MultiTalk 相关节点会拿到空值,他的解释是新版编码器默认不返回中间层,需要给编码器挂 forward hook 把各层特征取出来。这一点没有独立验证,最省事的做法是先把 transformers 固定在插件要求的版本。
权重 26GB,每次开机重新下载会把时间都耗在 IO 上。那位实践者的做法是:第一次下到云端,备份进网盘;之后每次开机并发拉进实例的本地 NVMe,再软链接进 ComfyUI 的 models 目录。
第三步:本地遥控云端
云端 ComfyUI 起在 127.0.0.1:8188,用 cloudflared 开一条临时隧道得到 HTTPS 地址:
cloudflared tunnel --url http://127.0.0.1:8188这个地址没有任何鉴权,拿到的人都能提交任务,用完就关。本地脚本只需要走 ComfyUI 的 HTTP 接口:
- 用
/upload/image把定妆照和音频传进云端 ComfyUI 的 input 目录(这个接口名叫 image,实际按原文件名保存任意文件,音频也能传) - 在 ComfyUI 里用“Export (API)”(旧版菜单叫“Save (API Format)”)导出工作流 JSON,把加载图片、加载音频节点里的文件名改成上传后返回的名字,提交到
/prompt - 轮询
/history/<prompt_id>等完成 - 从 history 的 outputs 里取出文件名,通过
/view把成片拉回本地
import requests, time

BASE = "https://<你的隧道地址>"

def upload(path: str) -> str:
    with open(path, "rb") as f:
        r = requests.post(f"{BASE}/upload/image",
                          files={"image": f},
                          data={"type": "input", "overwrite": "true"})
    r.raise_for_status()
    return r.json()["name"]          # 填进工作流里的文件名

def submit(workflow: dict) -> str:
    r = requests.post(f"{BASE}/prompt", json={"prompt": workflow})
    r.raise_for_status()
    return r.json()["prompt_id"]

def wait(pid: str, every=10) -> dict:
    while True:
        h = requests.get(f"{BASE}/history/{pid}").json()
        if pid in h:
            return h[pid]
        time.sleep(every)

def download(result: dict, dst="out_480p.mp4"):
    # VideoHelperSuite 的视频输出一般在 "gifs" 键下,以你安装版本的实际返回为准
    for node in result["outputs"].values():
        for item in node.get("gifs", []) + node.get("videos", []):
            r = requests.get(f"{BASE}/view", params={
                "filename": item["filename"],
                "subfolder": item.get("subfolder", ""),
                "type": item.get("type", "output")})
            r.raise_for_status()
            open(dst, "wb").write(r.content)
            return dst
成片拉回后,在本地用 ffmpeg 放大并换回原始高清音轨(横屏示例;竖屏把 scale=-2:720 改成 scale=720:-2):
ffmpeg -i out_480p.mp4 -i voice_norm.wav \
  -vf scale=-2:720:flags=lanczos \
-map 0:v -map 1:a -c:v libx264 -crf 18 -c:a aac -shortest final.mp4渲完立刻停实例。这一步最容易忘,也是账单失控的主要来源。
第四步:长视频防漂移的三个办法
InfiniteTalk 的 README 自己就写了:单图生成一分钟以内效果较好,超过一分钟色彩偏移会更明显。要做几分钟的口播,需要三招:
1. 滑窗要有重叠,并开颜色匹配。kijai 的 WanVideoImageToVideoMultiTalk 节点(界面显示名为 WanVideo Long I2V Multi/InfiniteTalk)按窗口生成:frame_window_size 默认 81 帧;motion_frame 是相邻窗口的重叠帧数,默认 25,越大衔接越顺但越耗算力;colormatch 默认关闭,可选 mkl、hm、reinhard 等方法,开启后能缓解逐窗变暗变色。那位实践者用的是 81 / 9 / mkl,社区工作流里也有 121/9、117/25 等不同组合,没有统一最优,按你的素材试。注意 ComfyUI 官方原生的 InfiniteTalk 节点是另一套,参数名不同,不能混用。
2. 在静音处切段。那位实践者的做法是音频超过 45 秒就切块,不一次喂进去。用 ffmpeg 找静音点,在换气处切:
ffmpeg -i voice_norm.wav -af silencedetect=noise=-35dB:d=0.25 -f null - 2>&1 | grep silence_3. 用上一段的尾帧做下一段的起始图。同样来自那位实践者:每段渲完,抽最后一帧当下一段的参考图,人物姿态和光线更容易接上。
排错表
| 现象 | 常见原因 | 处理 |
|---|---|---|
| 音频相关节点报 NoneType | transformers 版本与插件不匹配(实践者记录) | 固定版本,或补 forward hook |
| 嘴型对不上中文 | 换掉了官方的中文音频编码器 | 换回 chinese-wav2vec2-base |
| 嘴张不开 / 嘴型崩 | 音量过小或忽大忽小 | 先做 loudnorm |
| 渲到后面画面变暗偏色 | 窗口之间没有颜色约束,或单段过长 | 开 colormatch,缩短单段 |
| 小显存卡能跑但很慢 | 开了 offload / 块交换,时间耗在搬运上 | 租大显存卡,关掉换出 |
| 账单超预期 | 渲完没关实例 | 脚本末尾强制停止实例 |
成本和边界
那位实践者给的参考数字:在 96GB 显存的云端卡上,渲约 38 秒成片用了近 10 分钟;做一分钟成片端到端约 15 到 20 分钟。这是一个人的记录,你的素材、分辨率、步数不同,结果会有很大出入,请自己跑一遍当基准。
还有两点要提醒:
- 许可要自己核对。InfiniteTalk 官方仓库 README 写的是模型采用 Apache 2.0 许可,但也有来源称仅限学术用途;底座 Wan2.1 和各个 LoRA 的许可也要分别看。商用前逐一核对。
- 别拿别人的脸和声音。参考图、参考音频用自己的或有授权的,生成内容建议标注 AI 生成。
小结:一张可保存的清单
- 文案先口语化,再合成;声音定稿、统一响度(记得
-ar 48000),再上云 - 本地做所有要反复试的事,云端只做渲染
- 音频编码器用 chinese-wav2vec2-base;固定 transformers 版本
- 权重放网盘,开机热同步到 NVMe,别每次重下
- 素材和音频走
/upload/image,成片走/view;隧道无鉴权,用完即关 - 超过一分钟:滑窗重叠 + colormatch + 静音切段 + 尾帧接力
- 渲完立刻停实例
你手头是什么配置的机器?你觉得“本地定稿、云端只渲一次”这个切法,换成你自己的场景哪一步最难落地?