Spark 免费,Databricks 凭什么估值 1900 亿美元
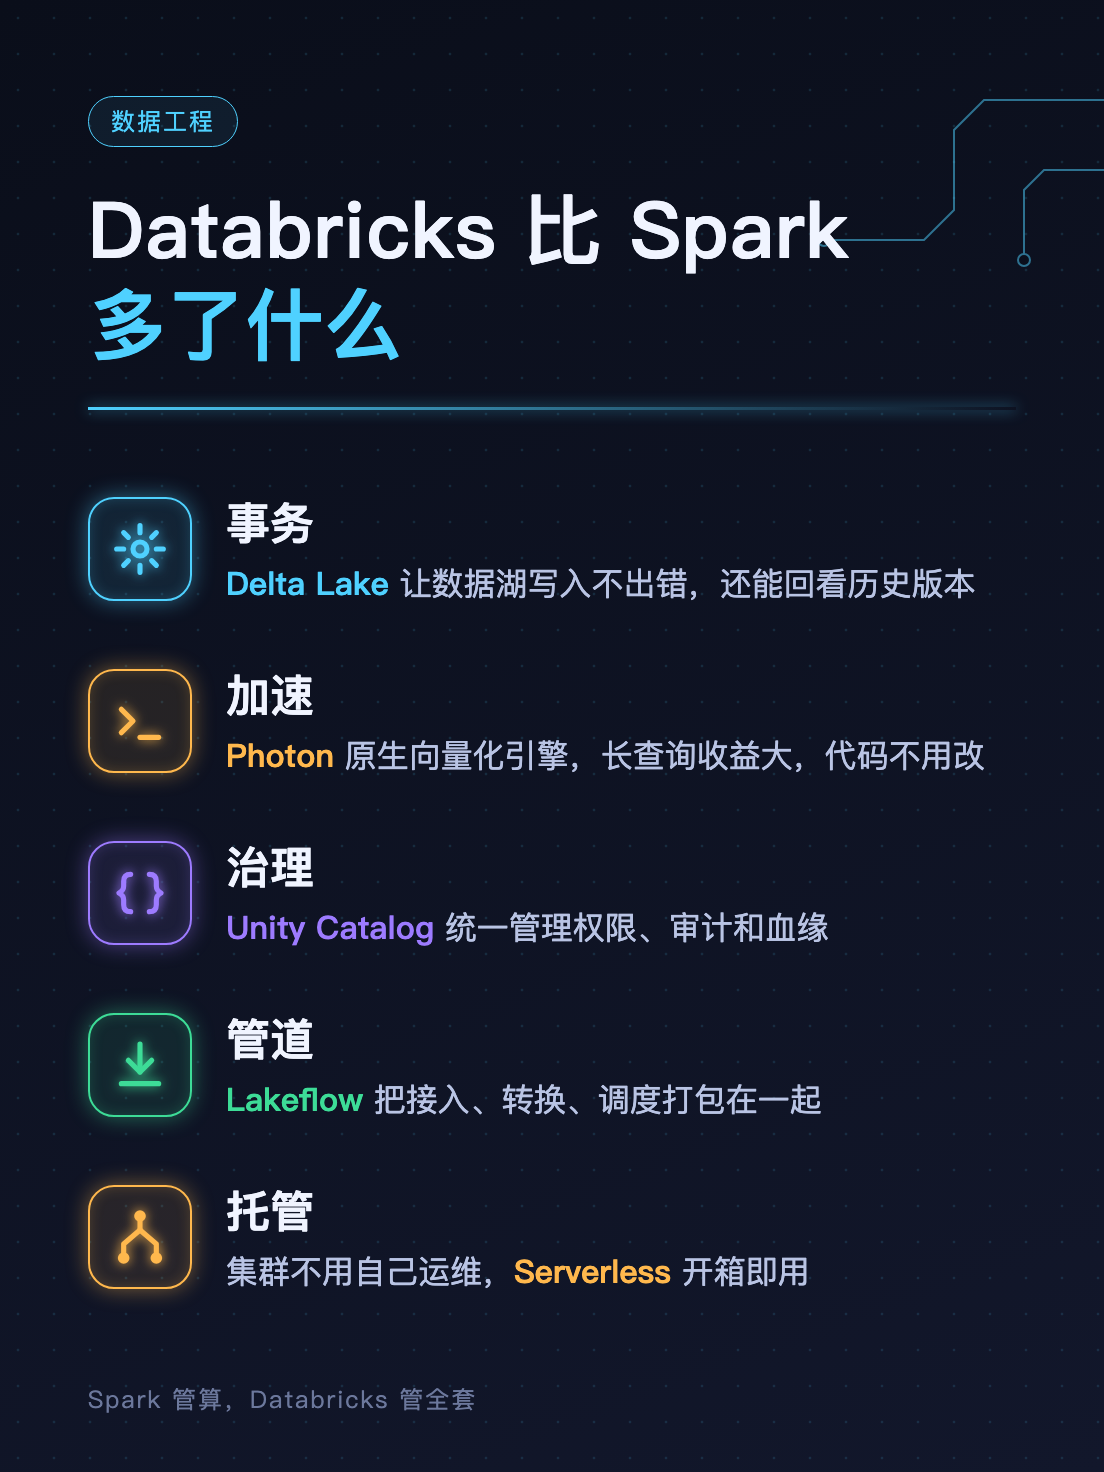
裸跑 Spark,集群、权限、脏数据,全得自己扛。
摘要
Databricks 的核心是 Spark,卖的却是 Spark 之外的五层东西:Delta Lake、Photon、Unity Catalog、Lakeflow 和全托管。本文逐层讲清多了什么、哪些已回流开源,以及国内怎么对标。
先分清:Spark 是引擎,Databricks 是整台车
Apache Spark 是开源的分布式计算引擎,管的是“把一大批数据算出来”。Databricks 由 Spark 的原作者创办,卖的是围绕这个引擎搭起来的完整平台。
这家公司 2026 年 8 月宣布完成 50 亿美元融资,估值 1900 亿美元,年化收入运行率超过 70 亿美元(均为公司公布、媒体转述的数字)。引擎本身免费,钱是从引擎之外的部分赚来的。
那些部分,大致就是五层。
| 层 | Spark 本身 | Databricks 多出来的 |
|---|---|---|
| 存储与事务 | 读写文件,没有事务 | Delta Lake:ACID 事务、历史版本 |
| 执行引擎 | JVM 执行 | Photon:原生 C++ 向量化引擎 |
| 治理 | 只有元数据目录,没有统一权限 | Unity Catalog:权限、审计、血缘 |
| 管道与编排 | 自己写、自己调度 | Lakeflow:接入、声明式管道、作业编排 |
| 运维 | 自己管集群 | 全托管、Serverless、笔记本协作 |
第一层:Delta Lake,让数据湖不再“写坏就坏”
用 Spark 往对象存储里写 Parquet 文件,没有事务。写到一半任务挂了,目录里留下半截文件,下游读到的就是脏数据。两个任务同时写同一张表,更是各写各的。
Delta Lake 在文件之上加了一层事务日志,提供 ACID 事务和 schema 校验。每次写入都是一个版本,因此还能回看历史:
# 写入 Delta 表
df.write.format("delta").mode("append").save("/data/orders")

# 读取第 3 个版本的数据
spark.read.format("delta").option("versionAsOf", 3).load("/data/orders")
它是 Databricks 从 2017 年开始做的,2019 年 4 月开源,同年 10 月捐给了 Linux Foundation。所以这一层你在开源 Spark 上也能用,只是要自己配依赖和参数。
第二层:Photon,同样的代码跑得更快(但有条件)
Photon 是 Databricks 自研的向量化查询引擎,用 C++ 写成,按列批量处理数据。查询计划仍由 Spark 的 Catalyst 优化器生成,Photon 只接管执行。代码不用改,不支持的算子会自动退回普通 Spark 运行时,结果不受影响。
它不是万能的,官方文档写得很清楚:
- 对大数据量的长查询帮助最大,本来两秒内就跑完的查询基本没提升;
- UDF、RDD API 和 Dataset API 不在支持范围内;
- 流处理只支持写入 Delta 或 Parquet 的无状态流,有状态的不支持;
- 开启 Photon 的实例按不同的 DBU 速率计费,要自己算账。
网上流传的“快 N 倍”多是厂商或第三方在特定负载下的测试,别直接当成你的预期,用自己的查询跑一遍最准。
这一层不开源,是商业版独有的。
第三层:Unity Catalog,把权限和血缘收到一处
数据一多,问题就从“算不算得出来”变成“谁能看哪张表”“这张表是谁产出的”。Unity Catalog 是 Databricks 的统一治理层,管权限、审计和数据血缘。
2024 年 6 月它的服务端开源(Apache 2.0),项目托管在 Linux Foundation 旗下的 LF AI & Data 基金会,兼容 Hive metastore 接口和 Iceberg 的 REST catalog 接口,Spark、Trino、DuckDB 等都能接。但要注意,开源版不等于商业版:托管的血缘展示、可视化的目录浏览器等功能,仍然只在商业产品里。
第四层:Lakeflow,管道和调度一起打包
Lakeflow 是 Databricks 的数据工程套件,分三块:
- Connect: 负责数据接入;
- Spark Declarative Pipelines: 前身是 Delta Live Tables(先改名 Lakeflow Declarative Pipelines,现名 Lakeflow Spark Declarative Pipelines),用声明的方式写转换逻辑,旧代码不用迁移;
- Jobs: 做编排,能跑笔记本、管道、SQL 和机器学习任务,支持 if/else 分支和 for each 循环。
“声明式管道”的思路已经进了开源 Spark:Spark 4.1 带了 Spark Declarative Pipelines,你只描述数据集和查询,依赖顺序、并行、检查点和重试由 Spark 处理。
Lakeflow Jobs 的定位和 Airflow 这类编排器相近,区别是它内置在平台里。好处是和其他部分打通,代价是被绑在这个平台上。
第五层:全托管,省的是人
最后一层最不起眼,也最值钱:集群的创建、扩缩容、版本升级、监控,Serverless 之后连实例类型都不用选。对不少中小团队来说,养一个专职 Spark 运维的人力成本,可能比平台账单还高。
想上手看看,Databricks 在 2025 年 6 月推出了 Free Edition,旧的 Community Edition 已于 2026 年 1 月 1 日退役:免费、不用信用卡,只提供 Serverless 计算,包含 Unity Catalog、Delta Lake 和 Lakeflow。限制也有,比如 Databricks App 有数量上限且 24 小时后自动停止,出网访问受限,长期不活跃的账号可能被删除。
国内怎么对标
没有一个产品能完整等价,要分层来看:
- 阿里云: 曾与 Databricks 合作推出托管产品“数据洞察 DDI”,据阿里云开发者社区的文章,该产品已停服,社区推荐的对标产品是 AnalyticDB MySQL 湖仓版,自带 Serverless Spark,支持 Delta、Hudi、Iceberg 三种开放表格式。MaxCompute 则更偏超大规模的离线批量数仓。以上来自社区文章而非官方公告,选型前请以阿里云官网为准。
- 其他云厂商: 华为云、腾讯云、火山引擎都有各自的大数据套件,侧重点不同。
- 自建开源栈: 不少大厂选择 Spark 或 Flink,加 Iceberg、Paimon 或 Hudi 表格式,再配 Doris 或 StarRocks 做分析,自己拼出湖仓。灵活、不被绑定,代价是治理、编排、运维都得自己补。
该不该上 Databricks
- 数据量不大、团队没有专职数据运维:托管平台能省下的人力很可观;
- 已经有成熟的 Spark 运维团队、对厂商绑定敏感:自建开源栈更稳;
- 数据必须放在国内、受合规约束:先确认目标云上的可用产品,别默认能直接用海外版。
小结
Spark 管“算”,Databricks 多出来的是“管”:管数据正确、管权限、管流程、管机器。其中 Delta Lake、Unity Catalog 的服务端和声明式管道的思路已经回流开源,Photon 和全托管体验仍是商业壁垒。
你们团队现在是自己维护 Spark 集群,还是已经上了托管平台?欢迎说说你的取舍。
项目地址:github.com/apache/spark