Strata 让普通游戏电脑跑 1250 亿参数大模型
摘要
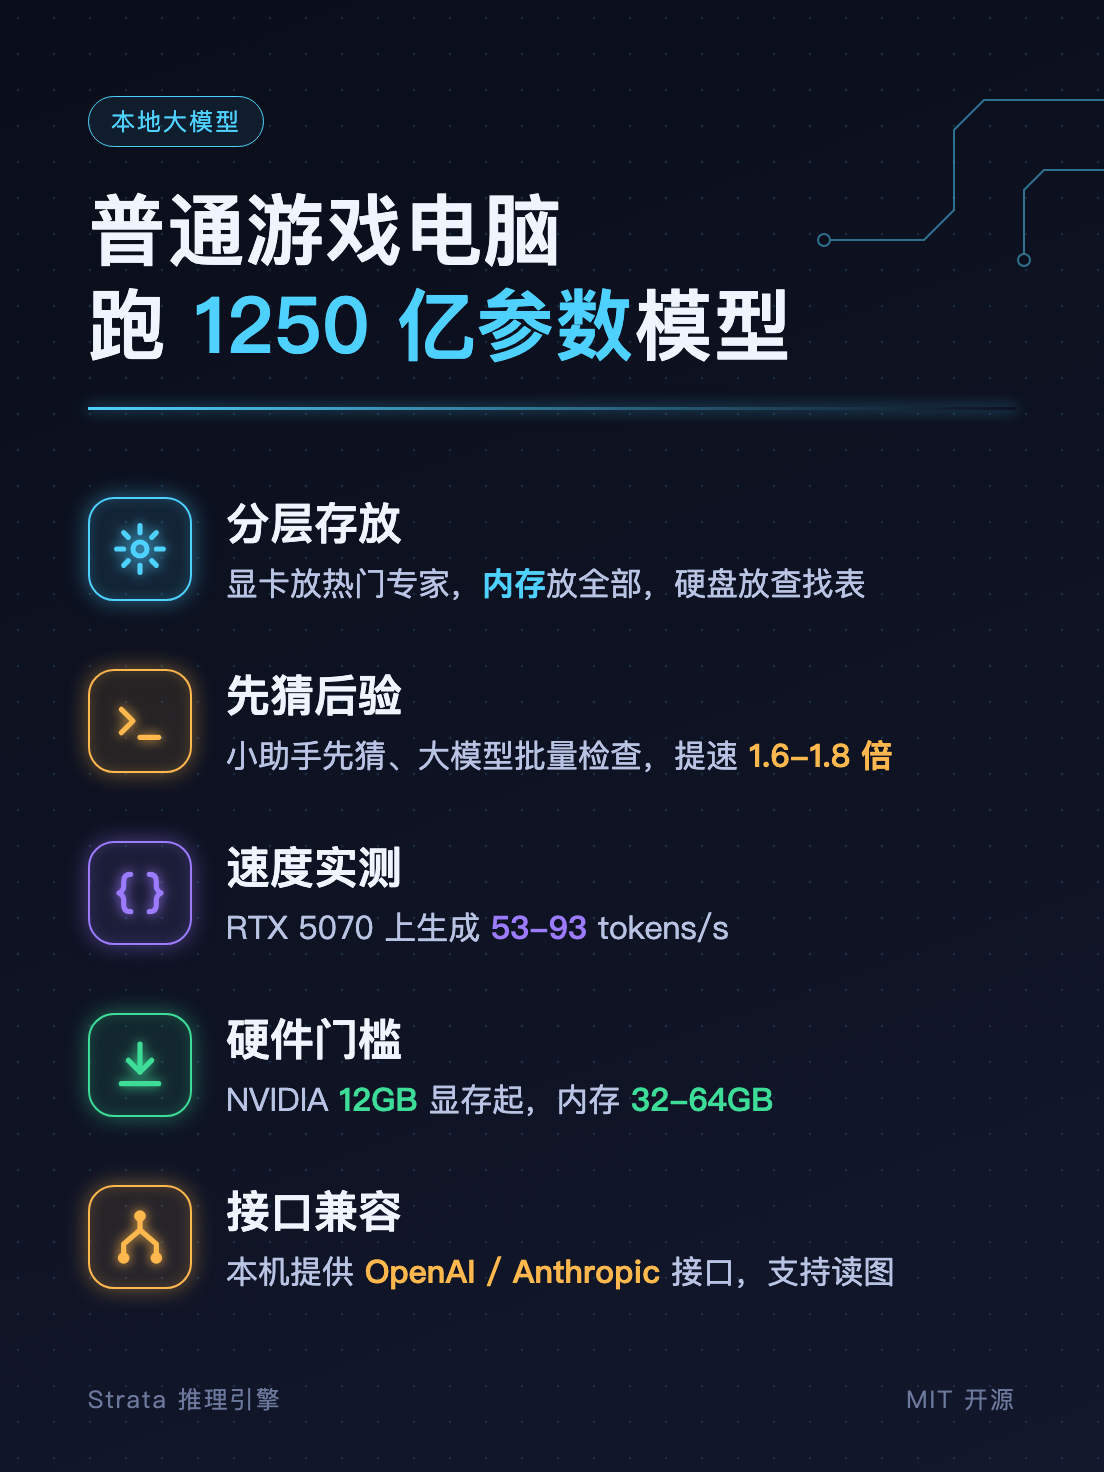
Strata 是一个开源推理引擎,能让一台带 NVIDIA 显卡的普通游戏电脑,跑起 1250 亿参数的 Qwen3.8-Flash-Next。Windows 和 Linux 都支持一键安装,装完在本机 8080 端口提供 OpenAI 和 Anthropic 两种兼容接口,还能直接喂图片。官方在 RTX 5070(12GB)上实测,生成速度 53 到 93 tokens/s,比人读字还快。
背景:大模型为什么总在服务器上
这类模型动辄需要几百 GB 显存,而一张游戏卡只有 12 到 24GB。差距太大,所以大家习惯了调云端接口。
Strata 的思路是别让显卡单打独斗,把整台电脑的资源都用起来,就像厨房里常用的调料放手边,其余的收进储物间。
核心优势
- 专家分层存放。 模型由 24576 个小专家组成,每生成一个词只调用其中 10 个。显卡只放每个词都要用的部分,以及被调用最频繁的几千个专家,并且会在使用中持续学习哪些最常用。全部专家放在内存里,显卡没有的由 CPU 同步计算,两边互不等待。硬盘上还有一张约 29GB 的查找表,每个词只读其中几小行。
- 先猜后验,提速 1.6 到 1.8 倍。 模型内置一个小助手,先猜接下来几个词,大模型一次性检查这些猜测,认可的就保留。每个词最终仍由大模型把关,所以回答质量不变,只是出字更快。
- 长文读得快。 长文按最多 8192 个 token 一块来读,长文档和代码库的读取速度能超过每秒 1000 token。
- 接口全兼容。 本机直接给出 OpenAI 风格接口和 Anthropic 风格接口,现有的聊天应用、编程助手改个地址就能接上。
- 支持图片输入, 网页里点「Picture」,终端里输入
/image加路径,应用里直接附图即可。 - 完全开源, 引擎采用 MIT 协议,模型文件各自遵循自己的许可。
速度到底怎么样
官方在 RTX 5070(12GB)、锐龙 5 7600、64GB 内存上的实测:
| 量化版本 | 短对话生成 | 128K 上下文生成 | 读取提示词 |
|---|---|---|---|
| Q2_0 | 93 tokens/s | 74 tokens/s | 2170 tokens/s |
| IQ2_XS | 79 tokens/s | 63 tokens/s | 2090 tokens/s |
| IQ3_XXS | 62 tokens/s | 49 tokens/s | 1750 tokens/s |
| IQ3_S | 53 tokens/s | 46 tokens/s | 1620 tokens/s |
显存更大的卡会更快,官方估计 RTX 3090(24GB)大约在 100 到 140 tokens/s。读 3.2 万 token 的提示词,用 Q2_0 大约 15 秒。
面向人群
- 想在本机跑大模型、不愿把代码和文档交给云端的开发者
- 手里有 12GB 以上显存的 RTX 20、30、40、50 系显卡,内存在 32GB 以上(64GB 最从容)的玩家
- 想给编程助手接一个本地后端,省掉接口费用的人
- 对「消费级硬件如何跑超大模型」的工程思路感兴趣的人
硬件要求(重点看这里)
先把门槛说清楚,避免踩坑:
- 显卡:NVIDIA RTX 20、30、40、50 系列,显存 12GB 及以上。双卡或三卡可以共同分担,此时每张卡需要 8GB 以上
- 内存:取决于选哪个版本。内存至少要比模型第一分片大 10GB 左右,留给系统和其他程序
- 硬盘:约 80GB 空闲空间,用固态硬盘首次启动会快很多
- 系统:Windows 10/11 或 Linux
- 驱动:需要自己装好较新的 NVIDIA 驱动,其余的 Python、引擎、模型都由安装脚本搞定
四个体积版本的取舍:
| 版本 | 内存加显存需求 | 特点 |
|---|---|---|
| Q2_0 | 37.6 GB | 最快,质量不错 |
| IQ2_XS | 39.2 GB | 较快,质量更好,官方推荐 |
| IQ3_XXS | 47.0 GB | 稍慢,质量很好 |
| IQ3_S | 54.8 GB | 最慢,质量最好,在公开测试上与完整模型持平 |
不确定就选 IQ2_XS。如果主要写代码,或者内存只有 32 到 48GB,可以选 Coder 版:它砍掉一半专家,只保留代码、工具调用和图片需要的部分,第一分片只有 29.6GB,32GB 内存就能跑。
快速上手
Windows: 下载项目压缩包并解压,双击 START-HERE.bat。它会问几个问题,包括选哪个模型和体积、上下文多长、要不要读图,一路回车就是推荐配置。随后自动下载约 70GB 的模型并启动,浏览器会打开本机 8080 端口的 Strata 页面。
Linux: 执行 ./setup.sh,问题和结果都一样。
Docker(Linux): 需要 NVIDIA Container Toolkit 和 580 以上的驱动。
docker build -t strata .
docker run --rm --gpus all -p 8080:8080 --ulimit memlock=-1 -v strata-data:/data strata
有两点要提前知道:
- 首次启动时,电脑可能卡顿 1 到 3 分钟,因为它要往内存里装 35 到 55GB 数据。这是正常现象,别关窗口。
- 下载中断了,重新运行脚本就会接着下,不会重复下载。
进阶用法
接入自己的应用。 在应用里添加一个「OpenAI 兼容」提供方,地址填下面这个,密钥和模型名随便填:
http://127.0.0.1:8080/v1使用 Anthropic 接口的应用,地址则是:
http://127.0.0.1:8080/v1/messages调节思考深度。 模型回答前会先思考,可以选关闭、低、中、高。关闭最快,高适合难题。网页里在菜单切换,终端里用 /think low,应用里用推理强度设置。
多卡共用。 直接运行 START-HERE.bat,它会列出可用的显卡并询问是否分摊。官方在 RTX 5080 加 RTX 3090 上测得,读提示词比单张 5080 快 18% 到 20%,生成速度持平。
测出你机器的最快设置。 运行 START-HERE.bat --calibrate,花 5 到 10 分钟测几项引擎参数并保留最快的一组,官方机器上让 Coder 版提速了 7%。
使用中要注意
- 它一次只处理一个请求,不适合多人并发
- 一段对话的第一条消息会被完整读取,大约每 3 万 token 需要 1 分钟,之后只读新增部分,追问几秒就开始回答
- 聊天记录只存在浏览器本地,换浏览器或开无痕窗口就是空的
- 如果要从手机或另一台电脑访问,务必设置密钥,不要把端口裸露在网络里
我的看法
Strata 最有价值的地方,是把「内存大、显卡小」这个普通人的现实条件,变成了可用的方案。它不追求单项极限,而是让显卡、CPU、内存、硬盘各干各的活。
当然也别神化它:12GB 显存加 48 到 64GB 内存(Coder 版也要 32GB)的门槛,依然不是人人都有,而且量化版本相比完整模型有精度损失,IQ3_S 才是官方称与完整模型持平的那一档。但对已经有这套硬件的玩家来说,本地跑一个 1250 亿参数的模型,已经从想象变成了双击就能完成的事。
项目地址:github.com/Niko1221/Strata