一文看懂 DeepSpeed ZeRO-3 与 MoE 训练
摘要
训练大模型,最先撞墙的不是算力,而是显存。ZeRO-3 的思路很朴素:别让每张卡都背一整份模型,把参数、梯度、优化器状态都切开,各卡只管自己那一份,用到别人的再临时借。MoE 则从另一个方向下手,把模型做得很大,但每个 token 只用其中几个“专家”。这篇文章用最通俗的方式讲清两者的原理,并一步一步带你把配置、代码、存档和 MoE 层都跑通,顺便讲清一个容易踩的坑:DeepSpeed 自带的 MoE 层目前不能和 ZeRO-3 一起用。
背景与问题
显存到底被谁吃掉了
先做一道小学算术题。假设你要训练一个有 Ψ 个参数的模型,用最常见的混合精度加 Adam 优化器,每个参数要占这些显存:
- 半精度参数:2 字节
- 半精度梯度:2 字节
- 优化器状态:12 字节(32 位的参数副本 4 字节,一阶动量 4 字节,二阶动量 4 字节)
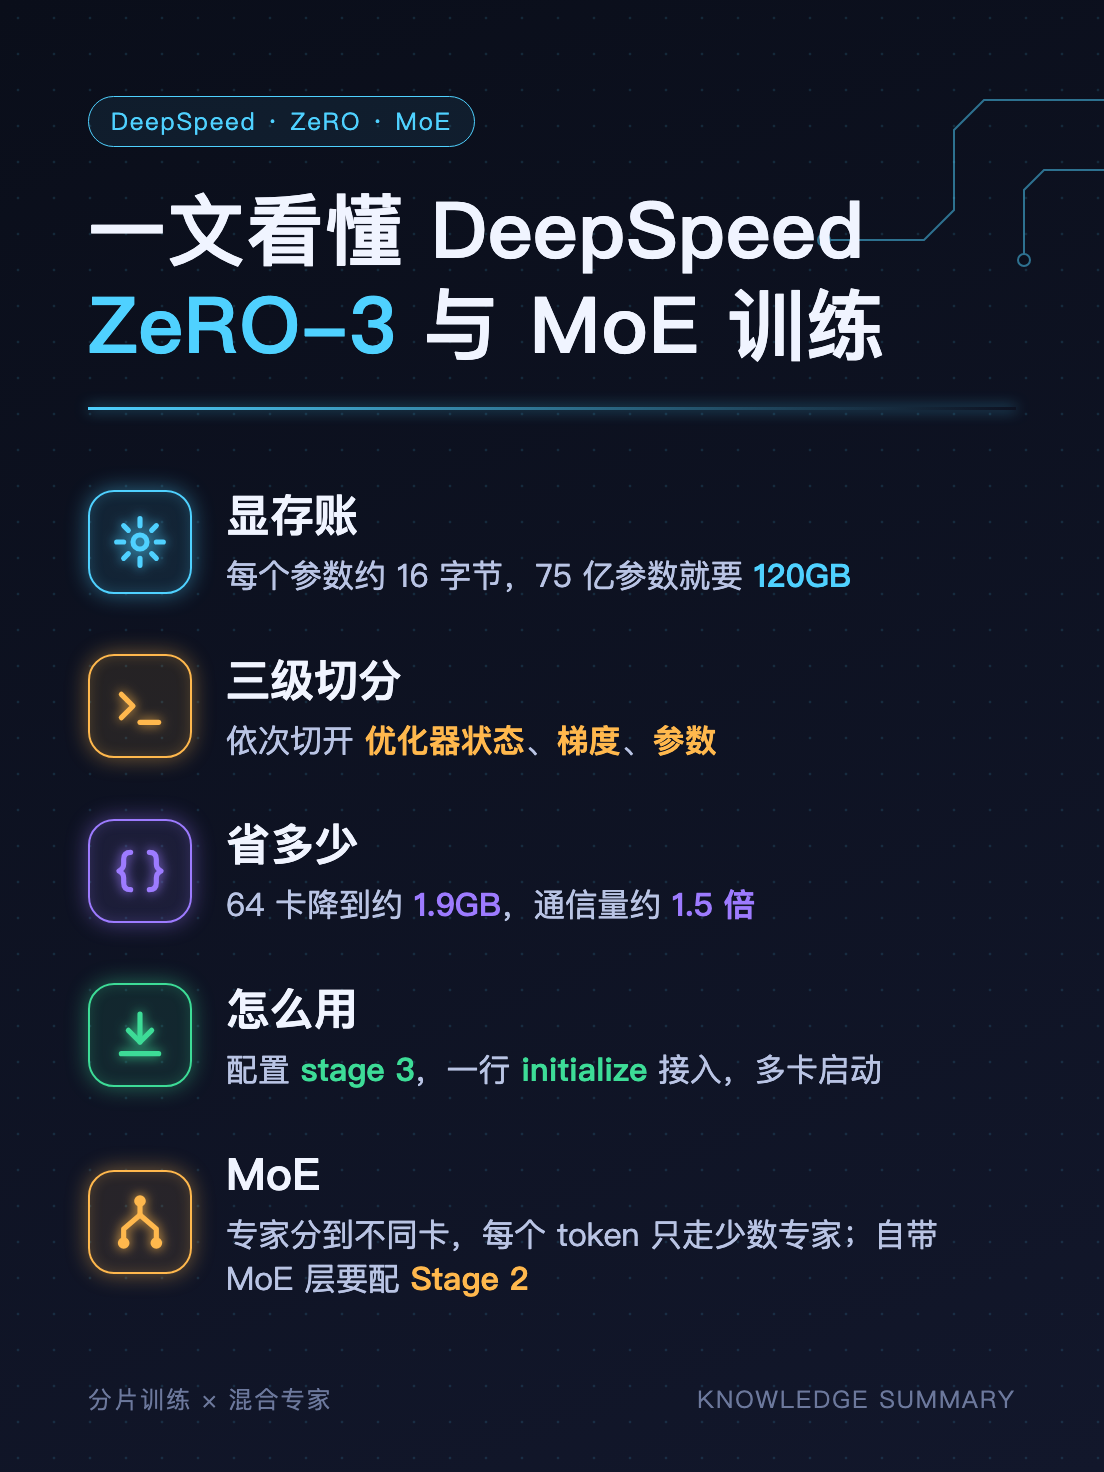
加起来是每个参数 16 字节。一个 75 亿参数的模型,光这三样就要 120GB,一张卡根本装不下。而且这还没算训练时的中间激活值。
普通数据并行为什么浪费
最常见的数据并行(DDP)是这样做的:每张卡都存一整份完整的 16Ψ,各自算不同的数据,再把梯度平均。
想象四个同学合租,每人都买了一整套同样的教材,只是各自做不同的习题。教材是一模一样的,四份里有三份纯属重复。这种“重复”,就是 ZeRO 要消灭的东西。ZeRO 的全称是 Zero Redundancy Optimizer,意思就是零冗余优化器。
另一个方向:稀疏化
还有一条思路是:模型总参数可以很多,但每次计算只用一小部分。这就是 MoE(Mixture of Experts,混合专家)。它本身不省显存(所有专家的参数都得存下来),省的是计算量,让“很大的模型”训练起来不至于慢到无法接受。
ZeRO 管“怎么装得下”,MoE 管“怎么算得动”,两者可以搭配使用。
核心思路与优势
ZeRO 的三级切分
ZeRO 把上面三类东西,按从易到难分三级切开,分给数据并行的所有卡:
- Stage 1:只切优化器状态。
- Stage 2:再切梯度。每张卡只保留自己那份优化器状态对应的梯度。
- Stage 3:再切参数本身。前向和反向过程中,用到哪一层就临时收集哪一层,用完立刻丢掉。
还是用合租的比喻,把“教材”对应参数,“批改意见”对应梯度,“复习笔记”对应优化器状态:Stage 1 是复习笔记不再每人抄一整份,四个人各记四分之一;Stage 2 是批改意见也各收各的那一部分;Stage 3 是连教材也拆成四份,每人只留四分之一,讲到哪一章,大家就把手里那一部分凑到一起、临时拼成完整的一章,用完各自只留回自己那份。
到底省多少:一张对照表
设参数量为 Ψ,数据并行的卡数为 N。以 ZeRO 论文和官方博客里的经典例子为准:75 亿参数,64 张卡。
| 方案 | 每卡显存公式 | 75 亿参数、64 卡 |
|---|---|---|
| 普通数据并行 | 16Ψ | 120GB |
| ZeRO Stage 1 | 4Ψ + 12Ψ/N | 约 31.4GB |
| ZeRO Stage 2 | 2Ψ + 14Ψ/N | 约 16.6GB |
| ZeRO Stage 3 | 16Ψ/N | 约 1.9GB |
注意 Stage 3 这一行,显存占用随卡数线性下降:卡越多,每张卡越轻松。这些数字只包含模型状态,不含激活值。
代价:通信量多了一半
天下没有免费的午餐。Stage 1 和 Stage 2 的通信量和普通数据并行一样,而 Stage 3 需要在前向、反向两次收集参数,再加一次梯度归约,通信量大约是普通数据并行的 1.5 倍。
所以 Stage 3 适合的场景是:模型装不下,或者你想用更大的批次。如果单卡能装下,用 Stage 1 或 Stage 2 往往更快。
MoE:让模型“大而不重”
普通的 Transformer 里,每个 token 都要经过同一个前馈网络(FFN)。MoE 把这一个 FFN 换成多个并列的 FFN,每一个叫一个“专家”,再加一个“路由器”,负责决定每个 token 交给哪几个专家。
- 路由器给每个 token 打分,选出得分最高的 k 个专家(k 常常是 1 或 2)。
- 其他专家这次不参与计算。
好处很直观:总参数量可以随专家数增加而暴涨,但每个 token 的计算量基本不变。比喻成医院:科室很多(模型很大),但你挂号后只去看相关的一两个科室(计算量小)。
专家并行:把专家分给不同的卡
专家太多,一张卡放不下,就把它们分开放。这叫专家并行,DeepSpeed 用参数 ep_size 表示专家并行组的大小。比如 8 个专家,ep_size=2,就是每组 2 张卡,每张卡放 4 个专家。
训练时,token 要“搬家”:路由器决定后,通过一次全员通信(all-to-all)把 token 送到装有对应专家的卡上,算完再送回来。
面向人群
- 想微调或预训练大模型,却总被“显存溢出”劝退的算法工程师
- 已经会用 DDP,想进一步理解 ZeRO 分片原理的开发者
- 想弄清 MoE 模型怎么训练的同学
- 需要给团队选训练框架,想搞明白 ZeRO 各阶段该怎么选的技术负责人
实践步骤
下面以“用 ZeRO-3 训练一个装不下的模型”为主线,最后再加上 MoE 层(这一部分要换成 Stage 2,原因到时候细说)。示例以写作时的最新稳定版 DeepSpeed 0.19.7 为准。
第一步:安装环境
pip install deepspeed
ds_report
ds_report 会检查 CUDA、编译环境和各个算子是否可用,先跑一遍,能提前发现大半环境问题。
第二步:写 ZeRO-3 配置文件
新建 ds_config.json:
{
  "train_micro_batch_size_per_gpu": 2,
  "gradient_accumulation_steps": 8,
  "bf16": { "enabled": true },
  "optimizer": {
    "type": "AdamW",
    "params": { "lr": 2e-5, "weight_decay": 0.01 }
  },
  "zero_optimization": {
    "stage": 3,
    "overlap_comm": true,
    "contiguous_gradients": true,
    "reduce_bucket_size": 5e8,
    "stage3_prefetch_bucket_size": 5e7,
    "stage3_param_persistence_threshold": 1e5,
    "stage3_gather_16bit_weights_on_model_save": true
  }
}
逐项解释,都是初学者最容易困惑的:
stage: 3:开启参数切分。train_micro_batch_size_per_gpu和gradient_accumulation_steps:每张卡每次算多少条数据,攒多少次再更新一次。总批次 = 单卡批次 × 累积步数 × 卡数。overlap_comm:让通信和计算重叠进行,尽量不让 GPU 干等。Stage 3 下它默认就是开启的,这里写出来只是为了看得清楚。contiguous_gradients:把梯度拷到连续内存,减少显存碎片。reduce_bucket_size:梯度归约时一批处理多少个元素,调大更省通信次数,调小更省显存。stage3_prefetch_bucket_size:提前预取多少参数。预取得越多越不容易等,但占用显存越多。stage3_param_persistence_threshold:小于这个数量的参数不切分,一直驻留在每张卡上,因为切它们省不了多少显存,反而增加通信。stage3_gather_16bit_weights_on_model_save:保存模型时先把各卡的分片聚合成一份完整的 16 位权重。Stage 3 下每张卡的state_dict里只有碎片,不聚合就拿不到能直接用的模型;但聚合既费时间又费显存,所以它默认是关闭的,需要手动打开。
第三步:把模型接入 DeepSpeed
训练脚本 train.py 的核心只有几行:
import deepspeed
import torch
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("your-model-name")

engine, optimizer, _, _ = deepspeed.initialize(
    model=model,
    model_parameters=model.parameters(),
    config="ds_config.json",
)

# dataloader 需要你自己准备,并用 DistributedSampler 让每张卡读到不同的数据
for batch in dataloader:
    batch = {k: v.to(engine.device) for k, v in batch.items()}
    loss = engine(**batch).loss
    engine.backward(loss)
    engine.step()
三点要记牢:
- 反向传播必须用
engine.backward(loss),不能再写loss.backward(),因为 DeepSpeed 要接管梯度的切分和累积。 - 更新参数用
engine.step(),它会按gradient_accumulation_steps自动判断这一步要不要真的更新。 - 优化器写在配置文件里时,不需要自己再创建。
第四步:启动多卡训练
deepspeed --num_gpus 8 train.py在一台 8 卡机器上,每张卡只会持有约八分之一的模型状态。启动器会给脚本自动传一个 --local_rank 参数,如果你的脚本用 argparse 解析参数,记得声明它(或者启动时加上 --no_local_rank)。多机训练时,再加上主机文件和节点参数即可,原理不变。
第五步:超大模型要在“出生时”就切分
如果模型大到连“加载进内存再切分”都做不到,就要用 deepspeed.zero.Init,让参数在创建的那一刻就被切开:
import deepspeed

with deepspeed.zero.Init(config_dict_or_path="ds_config.json"):
    model = MyLargeModel()

engine, _, _, _ = deepspeed.initialize(
    model=model,
    config="ds_config.json",
)
这样每个进程创建模型时,只会真正保留属于自己的那一份参数。这里没传 model_parameters,DeepSpeed 会默认使用模型的全部参数。
如果用的是 Hugging Face 的 from_pretrained,不用自己写这个 with:在调用 from_pretrained 之前,先用同一份配置创建一个 HfDeepSpeedConfig 对象(从 transformers.integrations 导入),并让它一直存活,加载时就会自动按 ZeRO-3 切分。
第六步:显存还不够,就往内存和硬盘借
ZeRO-3 加上卸载功能,就是 ZeRO-Infinity。在配置里加上:
"zero_optimization": {
  "stage": 3,
  "offload_optimizer": { "device": "cpu" },
  "offload_param": { "device": "cpu" }
}
把优化器状态和参数放到 CPU 内存,device 也可以改成 nvme,放到固态硬盘上。代价是速度变慢,因为数据要在 GPU 和内存之间来回搬,所以应当作“最后的手段”:先调小批次、开激活检查点,还不行再用卸载。
第七步:保存和合并权重
训练中保存的是分片存档:
engine.save_checkpoint("./checkpoints", tag="step_1000")每张卡会存自己那一份,之后用来恢复训练最方便。但如果要拿去推理或者分享,需要合并成完整权重。有两种办法:
# 办法一:训练结束时直接保存合并后的 16 位模型
engine.save_16bit_model("./final_model")

# 办法二:从分片存档离线合并成完整的 32 位权重
from deepspeed.utils.zero_to_fp32 import get_fp32_state_dict_from_zero_checkpoint

state_dict = get_fp32_state_dict_from_zero_checkpoint("./checkpoints")
办法一要求配置里打开了 stage3_gather_16bit_weights_on_model_save,这也是前面配置里我们把它设成 true 的原因;没打开的话,它会跳过保存并返回 False。另外,save_checkpoint 和 save_16bit_model 都必须在所有进程上一起调用,千万别套在“只在 0 号卡执行”的判断里,否则各卡互相等待,程序会卡死。
办法二会把完整的 32 位权重一次性读进 CPU 内存,模型很大时要留足内存。
第八步:给模型加上 MoE 层
先理解一件事:MoE 层替换的是 Transformer 里的 FFN。DeepSpeed 提供了现成的 MoE 层。
但要先打个预防针:DeepSpeed 自带的这个 MoE 层不能和 ZeRO-3 一起用。在当前最新的 0.19.7 版里,只要模型里有它、配置又是 Stage 3,deepspeed.initialize 会直接报错,提示改用 Stage 1/2 或者 AutoEP。所以从这一步开始,我们换一份 Stage 2 的配置,下一步会给出。
import torch
from deepspeed.moe.layer import MoE

class Expert(torch.nn.Module):
    def __init__(self, hidden):
        super().__init__()
        self.net = torch.nn.Sequential(
            torch.nn.Linear(hidden, hidden * 4),
            torch.nn.GELU(),
            torch.nn.Linear(hidden * 4, hidden),
        )

    def forward(self, x):
        return self.net(x)

class Block(torch.nn.Module):
    def __init__(self, hidden):
        super().__init__()
        self.moe = MoE(
            hidden_size=hidden,
            expert=Expert(hidden),
            num_experts=8,
            ep_size=2,
            k=1,
        )

    def forward(self, x):
        out, l_aux, _ = self.moe(x)
        return out, l_aux
参数含义:
expert:一个专家的结构,DeepSpeed 会在每张卡上把它复制成“本卡该放的专家数”份,也就是num_experts / ep_size份。num_experts=8:总共 8 个专家。ep_size=2:专家并行组大小为 2,也就是每 2 张卡为一组,这 8 个专家平均分在这两张卡上,每张 4 个。num_experts必须能被ep_size整除,总卡数也要能被ep_size整除。比如 8 卡机器上就会有 4 个这样的组,每组都有完整的 8 个专家,组和组之间再按数据并行同步专家的梯度。k=1:每个 token 只送给得分最高的 1 个专家。
MoE 层会返回三样东西:输出、一个辅助损失 l_aux,以及各专家的负载计数。辅助损失的作用是逼着路由器把 token 均匀分给各个专家,避免“总有几个专家累死,其他专家闲死”。训练时,通常把它乘一个小系数加到主损失上,比如:
loss = task_loss + 0.01 * l_aux第九步:换成 Stage 2 配置,并给参数分组
前面说过,自带 MoE 层要配 Stage 1 或 Stage 2。新建一份 ds_config_moe.json,和官方 MoE 教程的思路一致,用 Stage 2,显存紧张时再把优化器状态卸载到 CPU:
{
  "train_micro_batch_size_per_gpu": 2,
  "gradient_accumulation_steps": 8,
  "bf16": { "enabled": true },
  "optimizer": {
    "type": "AdamW",
    "params": { "lr": 2e-5, "weight_decay": 0.01 }
  },
  "zero_optimization": {
    "stage": 2,
    "overlap_comm": true,
    "contiguous_gradients": true,
    "offload_optimizer": { "device": "cpu" }
  }
}
然后是参数分组。专家的参数只在专家并行组内切分,普通参数则在所有数据并行的卡上共享,两者的梯度同步方式不同,所以优化器要把它们分成不同的组:
from deepspeed.moe.utils import split_params_into_different_moe_groups_for_optimizer

params = {"params": list(model.parameters()), "name": "parameters"}
param_groups = split_params_into_different_moe_groups_for_optimizer(params)

engine, optimizer, _, _ = deepspeed.initialize(
    model=model,
    model_parameters=param_groups,
    config="ds_config_moe.json",
)
补充一点:像这里这样把优化器写在配置文件里时,DeepSpeed 发现模型里有 MoE 层,会自动做这个分组,手动调用也不会出错;如果你是自己在代码里创建优化器(比如直接用 torch.optim.AdamW),就必须先用这个函数拆好再传进去。专家并行组同样由 DeepSpeed 在内部自动创建,不需要你手写通信组。
如果一定要 ZeRO-3 + MoE:AutoEP
模型实在太大、必须上 ZeRO-3 时,DeepSpeed 给的路是 AutoEP(自动专家并行)。它不需要你手写 MoE 层,而是在 deepspeed.initialize 时自动识别 Hugging Face 模型里的 MoE 层,替换成支持专家并行的版本。截至 0.19.7,内置支持的模型家族有 Mixtral、Qwen3-MoE、Qwen3.5-MoE、DeepSeek-V2 和 DeepSeek-V3,并且要求 Transformers 5.0 及以上(Qwen3.5-MoE 要 5.2 及以上)。配置大致是这样:
"expert_parallel": {
  "enabled": true,
  "autoep_size": 4,
  "preset_model": "mixtral"
}
AutoEP 支持 Stage 0、1、2,以及“有条件的” Stage 3:Stage 3 下不能再同时用自带 MoE 层、自动张量并行、序列并行、梯度量化等功能。这部分功能更新很快,升级版本后最好重新看一眼官方的 AutoEP 文档。
常见问题排查
- 一开始就显存溢出:先把
train_micro_batch_size_per_gpu降到 1,再考虑开激活检查点,最后才用卸载。 - 训练速度很慢:确认
overlap_comm已开启;检查卡间带宽,Stage 3 对通信很敏感,跨机器训练时网络是瓶颈。 - 保存的模型加载不了:分片存档不能直接当普通权重用,要先合并。
- 加了 MoE 层后一初始化就报错:看看配置是不是还停在 Stage 3。自带
MoE层只能配 Stage 1/2,要 Stage 3 就得换成 AutoEP。 - MoE 训练不稳定:观察各专家的负载是否均衡,适当调整辅助损失的系数。
- 不确定该用哪一级:能用 Stage 1 或 2 装下,就不要上 Stage 3;Stage 3 是“装不下”时的选择。
我的看法
ZeRO 和 MoE 其实解决的是同一个大问题的两个侧面:模型越来越大,一张卡装不下,也算不起。ZeRO 靠“分而治之”把冗余消掉,MoE 靠“按需激活”把计算省掉。
对大多数团队来说,学习路径很清晰:先用 Stage 2 把训练跑起来,理解通信和显存的关系,再在装不下的时候切到 Stage 3,最后才是卸载和 MoE。要注意 MoE 这一步和 Stage 3 不能随便叠加:手写 MoE 层配 Stage 2,想要 Stage 3 就走 AutoEP。每一步都只多一个变量,出了问题也好定位。